Recherche vectorielle dans PostgreSQL : dédoublonner des milliers de locuteurs avec pgvector et HNSW
La plupart des articles sur pgvector parlent de RAG et de chatbots à base de LLM. Celui-ci porte sur un problème très concret, sans LLM : identifier qui parle à la télé et à la radio, à grande échelle, sans rien de plus exotique que PostgreSQL.
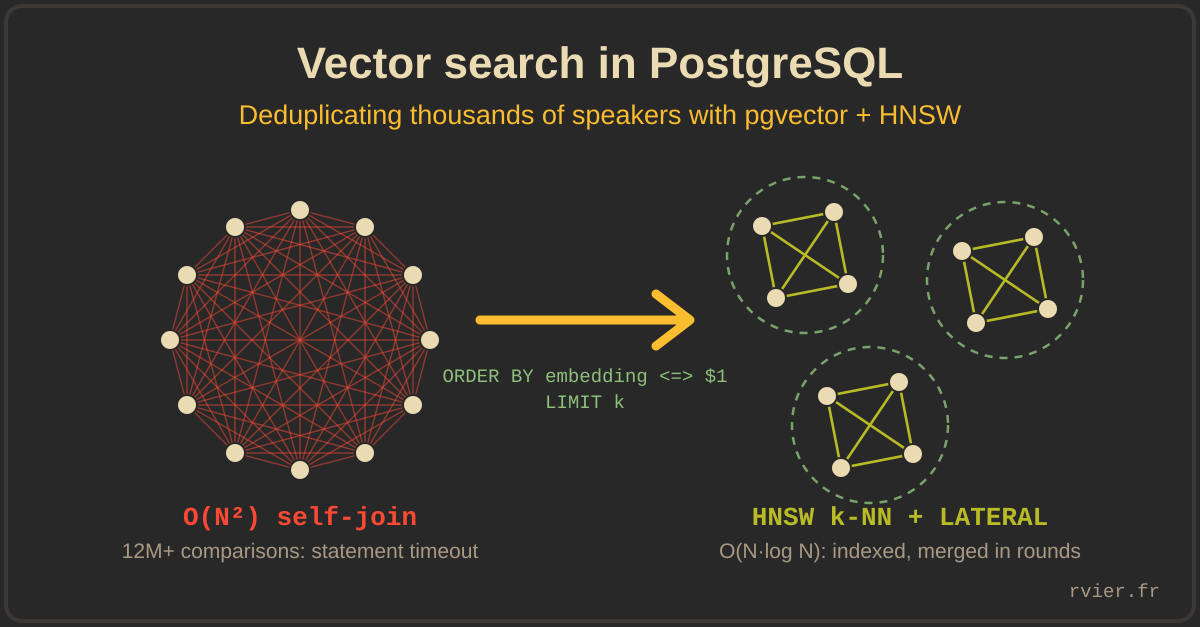
Le problème
Je travaille sur une plateforme d'analyse des médias qui fait tourner de la transcription automatique avec diarisation des locuteurs sur des flux broadcast, 24 h/24. Chaque segment diarisé produit un embedding vocal : un vecteur de 256 dimensions qui caractérise une voix. Deux segments de la même personne doivent donner des vecteurs proches en similarité cosinus ; deux personnes différentes, non.
L'objectif est une table speakers avec une ligne par personne réelle. Chaque locuteur accumule des empreintes (fingerprints), soit un embedding par segment, et porte un centroïde : la moyenne des embeddings de ses empreintes actives. Quand un nouveau segment arrive, on le compare aux centroïdes existants ; au-dessus d'un seuil de similarité (0,71 chez nous), il est rattaché au locuteur existant, sinon on crée un nouveau locuteur.
Le schéma ressemble à ceci :
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE speakers (
    id UUID PRIMARY KEY,
    name TEXT NOT NULL,
    embedding VECTOR(256),   -- centroid of active fingerprints
    status SMALLINT NOT NULL DEFAULT 0
);

CREATE TABLE speaker_fingerprints (
    id UUID PRIMARY KEY,
    speaker_id UUID NOT NULL REFERENCES speakers(id) ON DELETE CASCADE,
    embedding VECTOR(256),
    status SMALLINT NOT NULL DEFAULT 0
);

CREATE INDEX ON speakers USING hnsw (embedding vector_cosine_ops);
CREATE INDEX ON speaker_fingerprints USING hnsw (embedding vector_cosine_ops);
Un rapprochement par seuil n'est jamais parfait. La diarisation est bruitée, une voix change avec la qualité audio, et un segment juste à la limite crée parfois un tout nouveau locuteur pour une personne qui existe déjà. Après des mois d'ingestion continue, on se retrouve avec des locuteurs quasiment en double. Il faut donc un job de dédoublonnage périodique : trouver toutes les paires de locuteurs dont les centroïdes sont presque identiques, et les fusionner.
La version naïve : un self-join en O(N²)
La première implémentation était la plus évidente. On compare chaque locuteur avec tous les autres et on prend la meilleure paire au-dessus du seuil de fusion :
SELECT a.id, b.id,
       1 - (a.embedding <=> b.embedding) AS sim
  FROM speakers a
  JOIN speakers b ON a.id < b.id
 WHERE a.status >= 0 AND b.status >= 0
   AND 1 - (a.embedding <=> b.embedding) >= 0.92
 ORDER BY sim DESC
 LIMIT 1;
En démo, avec une centaine de locuteurs, ça marche très bien. Avec des milliers, c'est une catastrophe, et il faut comprendre pourquoi : l'index HNSW n'est pas utilisé du tout. Les index de pgvector n'accélèrent qu'une seule forme de requête : ORDER BY embedding <=> $1 LIMIT k. Une expression de distance placée dans une clause WHERE ou dans un prédicat de jointure est évaluée en force brute, par un parcours séquentiel qui calcule N×(N−1)/2 distances cosinus. Avec 5 000 locuteurs, cela fait plus de 12 millions de calculs de distance en 256 dimensions pour une seule requête. La nôtre a commencé à tomber en timeout, et pour ne rien arranger, le job appelait cette requête une fois par fusion.
La solution : demander à l'index k voisins par locuteur
L'idée est d'arrêter de demander « quelles paires sont au-dessus du seuil ? » (une question à laquelle l'index ne sait pas répondre) et de demander plutôt, pour chaque locuteur, « quels sont tes k plus proches voisins ? », ce qui est exactement la forme de requête pour laquelle HNSW est conçu. En SQL, cela s'écrit avec un CROSS JOIN LATERAL :
WITH raw_pairs AS (
    SELECT DISTINCT ON (LEAST(a.id, n.id), GREATEST(a.id, n.id))
           LEAST(a.id, n.id)    AS sid_a,
           GREATEST(a.id, n.id) AS sid_b,
           1 - (a.embedding <=> n.embedding) AS similarity
      FROM speakers a
      CROSS JOIN LATERAL (
          SELECT id, embedding
            FROM speakers
           WHERE status >= 0
             AND embedding IS NOT NULL
             AND id <> a.id
           ORDER BY embedding <=> a.embedding   -- HNSW kicks in here
           LIMIT 5                                -- k neighbours per speaker
      ) n
     WHERE a.status >= 0 AND a.embedding IS NOT NULL
       AND 1 - (a.embedding <=> n.embedding) >= 0.92
)
SELECT * FROM raw_pairs ORDER BY similarity DESC;
Trois détails comptent ici :
- La sous-requête est un
ORDER BY … LIMIT k: chacune des N lignes externes coûte donc une recherche k-NN indexée au lieu d'un parcours complet. Le coût total passe de O(N²) à environ O(N·log N). - Le k-NN renvoie chaque paire dans les deux sens (A trouve B, puis B trouve A).
DISTINCT ON (LEAST(id1, id2), GREATEST(id1, id2))réduit chaque paire non ordonnée à une seule ligne. - Le filtre sur le seuil est toujours là, mais il porte maintenant sur un petit ensemble de candidats (N×k lignes) au lieu de piloter la jointure.
Un petit k (5 chez nous) suffit. Si un locuteur a plus de k doublons fusionnables, le surplus n'apparaît tout simplement pas dans cette passe, et ce n'est pas grave, parce que la fusion se fait en plusieurs tours.
Fusionner en plusieurs tours, pas en une seule passe
On ne peut pas simplement prendre la liste des candidats et fusionner toutes les paires qu'elle contient. Chaque fusion déplace le centroïde du locuteur conservé (il est recalculé comme la moyenne des empreintes réunies) : une paire qui était au-dessus du seuil au moment où la liste a été construite n'est peut-être plus un vrai doublon deux fusions plus tard. L'inverse arrive aussi : une fusion peut rapprocher un centroïde d'un troisième locuteur.
La fusion en masse est donc une boucle :
- Récupérer toutes les paires candidates avec la requête indexée ci-dessus, triées par similarité décroissante.
- Parcourir la liste de façon gloutonne et fusionner, en sautant toute paire qui implique un locuteur déjà touché pendant ce tour. Chaque fusion d'un tour se fait donc entre deux locuteurs intacts, à partir de centroïdes à jour.
- Une fois la liste épuisée, commencer un nouveau tour : récupérer à nouveau les candidats avec les centroïdes qui ont bougé.
- S'arrêter quand un tour ne fait aucune fusion (avec un nombre maximal de tours, comme filet de sécurité contre une oscillation pathologique).
Chaque fusion garde le locuteur qui a le plus d'empreintes et y absorbe le plus petit, puis le centroïde est recalculé. C'est aussi là que sont rattrapés les doublons « en surplus » que la limite du k-NN avait laissés de côté : une fois que le premier tour a fusionné les paires les plus proches, les locuteurs conservés retrouvent leurs derniers doublons au deuxième tour.
Des centroïdes qui restent fiables
Un dernier élément stabilise l'ensemble. Un centroïde calculé à partir d'empreintes bruitées dérive, et une fusion peut importer quelques mauvais segments. Après chaque recalcul, chaque empreinte est réévaluée par rapport au nouveau centroïde : les empreintes actives qui passent sous un seuil de rejet des valeurs aberrantes sont désactivées, et, c'est la partie intéressante, les empreintes désactivées auparavant dont la similarité est maintenant au-dessus du seuil sont réactivées, parce que retirer les mauvais échantillons affine le centroïde et peut faire revenir des segments limites. Cette passe de désactivation/réactivation est répétée au plus trois fois, le temps que le centroïde converge. Tout cela reste du SQL simple : AVG(embedding) avec une clause FILTER, et deux UPDATE qui utilisent l'opérateur <=>.
Ce qu'il faut retenir
- L'index HNSW de pgvector accélère une seule forme de requête :
ORDER BY embedding <=> $1 LIMIT k. Si votre expression de distance se trouve dans une clauseWHEREou une condition de jointure, vous faites un parcours séquentiel, quels que soient les index en place. CROSS JOIN LATERALfait le pont : il transforme « tout comparer avec tout » en « une recherche k-NN indexée par ligne ».- HNSW est approximatif. Avec un petit k, une seule passe peut rater des paires. Concevez le processus autour (tours successifs, relances périodiques) pour que ces oublis soient rattrapés plus tard, au lieu de faire comme si l'index était exhaustif.
- Quand les entités sont des agrégats qui changent (des centroïdes), n'appliquez jamais en lot des décisions calculées sur un état périmé. Des fusions gloutonnes et sans chevauchement, tour par tour, font reposer chaque décision sur des données à jour, au prix de quelques tours de requêtes supplémentaires, qui ne coûtent plus grand-chose maintenant que les requêtes passent par l'index.
Aucune base de données vectorielle ni infrastructure en plus : PostgreSQL, une extension et la bonne forme de requête suffisent.