Fine-tuning d'EasyOCR sur ses propres images : guide pratique
Dans le billet sur l'OCR et les LLM, j'expliquais que notre plus gros gain de précision en OCR venait du fine-tuning du modèle de reconnaissance sur nos propres images. Plusieurs personnes m'ont demandé comment faire, et il faut dire que le fine-tuning d'EasyOCR est mal documenté : les briques existent (un script d'entraînement officiel, un mécanisme de réseau personnalisé), mais personne ne montre le chemin complet entre « des images de production » et easyocr.Reader(recog_network=...). Le voici, exactement comme nous l'avons parcouru.
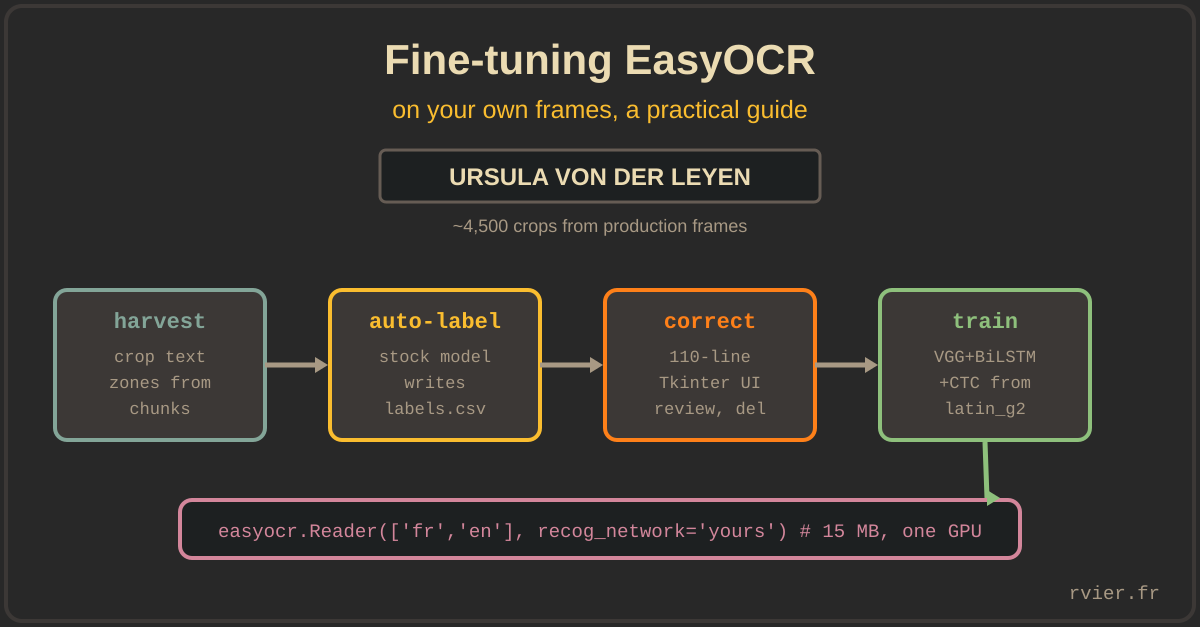
Le contexte : nous lisons les textes incrustés sur des images de télévision (le bandeau qui nomme la personne qui parle, celui qui annonce le sujet). C'est un domaine visuel fermé, avec les mêmes polices et les mêmes couleurs depuis des années, tout en majuscules et un crénage serré (kerning). Le modèle de reconnaissance latin d'origine est entraîné sur du texte générique photographié en situation (scene text), et il peine justement là où nos données sont particulières. Le fine-tuning corrige ça, et le tout tient sur un seul GPU et quelques soirées.
Étape 1 : récolter les découpes en production
Le jeu de données est construit par un script qui réutilise la plomberie de production : il récupère des segments vidéo, décode les images avec OpenCV et découpe les zones de texte configurées (les mêmes zones par chaîne que celles du worker de production). Chaque découpe (crop) est enregistrée en PNG, avec sa chaîne et son horodatage dans le nom du fichier.
Le jeu de données coûte peu parce que le modèle d'origine annote lui-même ses données d'entraînement. Chaque découpe passe dans EasyOCR tel qu'il est livré, et le texte prédit est ajouté à un labels.csv, à côté du chemin de l'image :
result = reader.readtext(crop, paragraph=True)
if result:
    cv2.imwrite(crop_path, crop)
    labels.write(f"{crop_path},{result[0][1]}\n")
Le modèle d'origine a raison la plupart du temps, et ses erreurs sont précisément ce qu'on veut lui faire désapprendre. En échantillonnant sur plusieurs chaînes et plusieurs jours (matinales d'info, émissions du soir, week-ends), nous avons obtenu environ 4 500 découpes annotées. Ici, la diversité compte plus que le volume : 4 500 découpes qui couvrent tous les styles de bandeaux valent mieux que 50 000 découpes de la même émission.
Étape 2 : corriger les annotations avec l'interface la plus bête possible
Les annotations automatiques doivent être vérifiées par un humain, et c'est là que la friction tue la plupart des projets de fine-tuning. Le nôtre a survécu parce que l'outil de correction est une application Tkinter de 110 lignes. Elle affiche la découpe (agrandie deux fois), le texte prédit dans un champ modifiable, et trois boutons : suivant (enregistre), supprimer (mauvaise découpe : zone vide, image de transition, bandeau à moitié affiché), aller à l'index. Entrée, Entrée, on corrige un mot, Entrée, supprimer, Entrée.
Corriger une annotation pré-remplie va bien plus vite que la taper, puisque la plupart sont déjà justes : on relit au lieu de transcrire. Une seule personne vient à bout de quelques milliers de découpes en deux ou trois séances. Résistez à l'envie de monter une application web avec des comptes et des barres de progression : le duo CSV et Tkinter a été écrit en une heure, et il a fait le travail.
Deux règles de sélection qui ont porté leurs fruits :
- Supprimer les découpes ambiguës plutôt que les corriger. Une découpe qui fait hésiter un humain apprend au modèle à hésiter.
- Écarter complètement les découpes où le modèle n'a rien lu. Le modèle de reconnaissance sert à lire du texte ; savoir s'il y a du texte à lire relève d'un filtrage qui se fait ailleurs dans le pipeline.
Étape 3 : entraîner avec le script d'EasyOCR
Le modèle de reconnaissance d'EasyOCR descend de deep-text-recognition-benchmark, et le projet fournit un script d'entraînement pour lui. L'architecture se choisit dans la configuration. La nôtre est identique à celle du modèle latin d'origine, puisqu'on affine un modèle existant au lieu d'en concevoir un nouveau :
Transformation: None
FeatureExtraction: VGG
SequenceModeling: BiLSTM
Prediction: CTC
input_channel: 1        # grayscale
output_channel: 256
hidden_size: 256
imgH: 64
imgW: 600               # banners are wide; don't squash them
batch_max_length: 34    # longest label in the dataset, plus margin
batch_size: 32
num_iter: 300000
saved_model: saved_models/latin/latin_g2.pth   # start from stock weights
new_prediction: True
sensitive: True
character: "0123456789!\"#$%&'()*+,-./:;<=>?@[\\]^_`{|}~ €ABC...àâäæçéèêëîïôœùûüÿ"
Les choix qui méritent une explication :
- Partir de
latin_g2, jamais de zéro. Les poids d'origine savent déjà à quoi ressemblent les glyphes : on leur apprend des polices et une mise en page, pas l'alphabet. Un entraînement à partir de zéro sur 4 500 images partirait simplement en surapprentissage (overfitting). new_prediction: Trueremplace la couche de classification finale, ce qui est nécessaire dès que votre jeu de caractères diffère de celui du modèle de base. Le nôtre est réduit à ce qui apparaît réellement dans les incrustations des chaînes françaises : chiffres, ponctuation, symbole euro et caractères accentués du français (114 classes au total). Une couche de sortie plus petite est déjà un petit gain en soi. Le plus gros, c'est de ne pas demander au modèle de distinguer des glyphes qu'il ne verra jamais.imgW: 600etimgH: 64, comme dans la config d'exemple d'EasyOCR, correspondent au format des vraies découpes. Il faut les garder : les 32×100 par défaut hérités de deep-text-recognition-benchmark supposent de petits fragments de texte de scène, et un bandeau large écrasé dans une entrée étroite perd justement les détails de crénage qu'on cherche à apprendre.- Sensible à la casse (
sensitive: True), même si les incrustations sont surtout en majuscules, parce que c'est dans la minorité en casse mixte (noms, titres) que les erreurs font le plus mal.
Quelques mises en garde pratiques. Le script d'entraînement est du code de recherche : attendez-vous à figer les versions des dépendances et à corriger de petites incompatibilités si votre PyTorch est plus récent que lui (c'était notre cas). Constituez le jeu de validation avec des découpes de jours et de chaînes absents de l'entraînement, sinon votre score mesure de la mémorisation. num_iter est une borne haute, pas un objectif : le script valide toutes les valInterval itérations et enregistre best_accuracy.pth. C'est ce checkpoint-là qu'il faut déployer, pas la dernière itération, qui peut avoir surappris les 4 500 découpes. Sur un seul GPU, cette configuration s'entraîne en une nuit.
Étape 4 : déployer avec trois fichiers
Le mécanisme de modèle de reconnaissance personnalisé d'EasyOCR attend trois fichiers :
~/.EasyOCR/model/yacast_filtered.pth          # the fine-tuned weights
~/.EasyOCR/user_network/yacast_filtered.py    # network definition (from the trainer)
~/.EasyOCR/user_network/yacast_filtered.yaml  # charset + network params + imgH
Le YAML doit reprendre exactement la liste de caractères et les paramètres réseau utilisés à l'entraînement. Si on a de la chance, une différence fait échouer le chargement ; sinon, elle brouille la sortie sans rien dire. Ensuite, changer de modèle tient en un seul paramètre :
reader = easyocr.Reader(['fr', 'en'], recog_network='yacast_filtered')
Tout le reste est identique. Le détecteur reste le modèle CRAFT d'origine (la détection se généralise bien, c'est la reconnaissance qui dépend du domaine), l'API ne change pas, et le worker de production n'a eu besoin d'aucune autre modification. Au final, on obtient un modèle de 15 Mo qui lit les incrustations de nos chaînes mieux que tous les modèles généralistes que nous avons essayés, EasyOCR d'origine compris.
À retenir
- Fine-tuner le modèle de reconnaissance et garder le détecteur d'origine : la détection se généralise, c'est la reconnaissance qui porte la spécificité de votre domaine.
- Laisser le modèle d'origine annoter ses propres données d'entraînement, et ne payer un humain que pour les corrections. Relire est plus rapide que transcrire d'un ordre de grandeur.
- L'outil de correction doit être simple au point d'en être gênant. Ce qui tue les petits projets de fine-tuning, c'est la friction, pas la qualité du modèle.
- Partir des poids pré-entraînés, réduire le jeu de caractères à votre domaine, et caler la géométrie d'entrée (
imgH,imgW) sur vos vraies découpes. - Valider sur des jours et des chaînes que l'entraînement n'a jamais vus, sinon votre métrique mesure de la mémorisation.
- Un modèle spécialisé de 15 Mo, un GPU, quelques milliers de découpes triées : il n'en faut pas plus pour battre un OCR généraliste sur un domaine fermé.