Lire l'écran : OCR et LLM auto-hébergés pour enrichir les transcriptions télé
Deux billets précédents expliquaient comment transcrire l'audio des flux broadcast avec Whisper et comment dédoublonner les voix des locuteurs dans PostgreSQL. Celui-ci porte sur les deux couches du dessus : lire ce qui est écrit à l'écran, et se servir de LLM pour faire d'une transcription brute quelque chose dans lequel un humain peut chercher, avec des titres, des mots-clés, des personnes, des lieux, des organisations et une classification thématique.
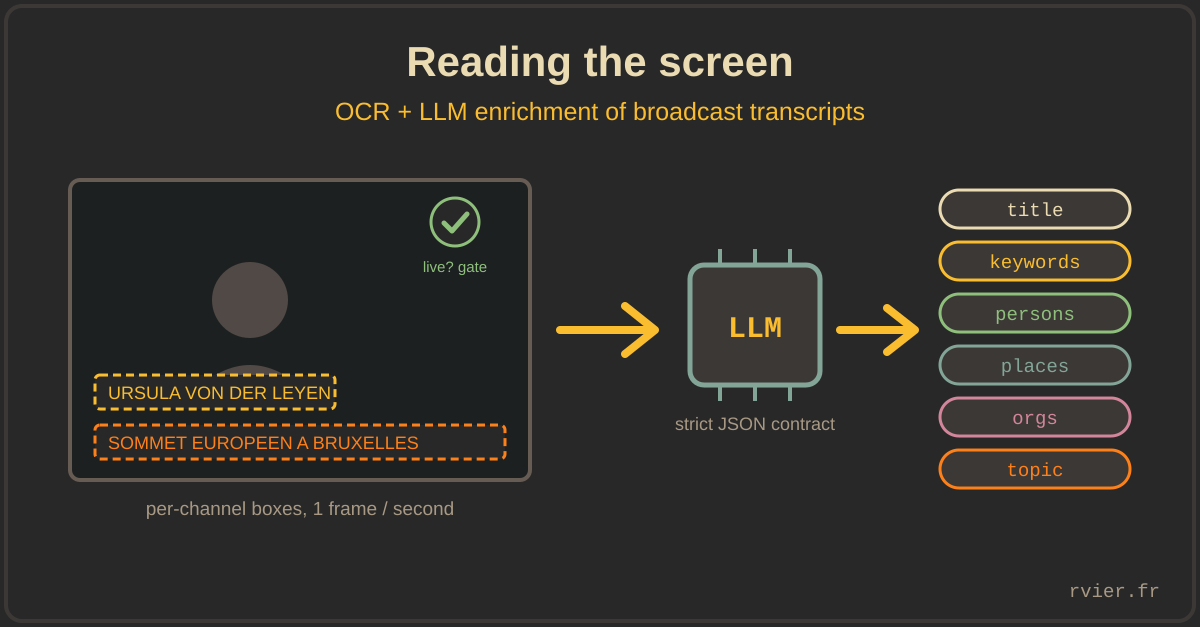
L'écran d'une chaîne d'info est rempli de métadonnées que la parole ne porte jamais : le nom de la personne qui parle s'affiche dans un bandeau, le sujet du moment dans un autre. Et la transcription elle-même, même parfaite, reste un pavé de texte diarisé. Les deux problèmes ont les mêmes contraintes de production que le pipeline STT : tourner 24/7, sans surveillance, et sans tricher sur son propre niveau de confiance.
Des zones par chaîne, dessinées une fois, stockées dans PostgreSQL
Un OCR générique « sur toute l'image » produit du bruit : bandeaux défilants, publicités, logos d'émissions. Ce qu'on cherche vraiment se trouve dans des zones stables que chaque chaîne conserve pendant des années. Chaque chaîne a donc ses zones (boxes) dans une table PostgreSQL : une zone pour le bandeau qui donne le nom de l'intervenant, une autre pour le bandeau du sujet. Elles sont stockées en coordonnées normalisées (indépendantes de la résolution), dessinées une fois dans une petite interface interne, et les workers les rechargent toutes les heures.
La passe OCR elle-même (EasyOCR, français et anglais) lit quand même l'image entière, à raison d'une image par seconde : les détections sont ensuite filtrées par zone, regroupées en lignes selon leur coordonnée Y, puis concaténées. Lancer la détection une seule fois et filtrer par zone coûte moins cher que lancer la reconnaissance sur une découpe par zone, et ça permet d'ajouter une zone sans toucher au worker.
Un tri presque gratuit avant tout OCR
La partie la plus rentable de tout le worker est un tri qui tourne avant la moindre extraction de texte. Les chaînes d'info françaises présentent les programmes en direct autrement que les publicités, les bandes-annonces et les rediffusions, et il existe un moyen rapide, presque gratuit, de les distinguer à partir de l'image elle-même (je garde le signal exact pour nous). Si l'image ne ressemble pas à un programme en direct, elle est ignorée en entier, sans OCR, donc sans résultat ni bruit. Ce seul contrôle évite de transcrire des bandeaux publicitaires toute la journée, et il coûte une fraction de la passe OCR proprement dite.
La confiance est un contrat, il faut la post-traiter honnêtement
Les consommateurs en aval filtrent les résultats OCR sur leur confiance, donc cette confiance doit vouloir dire quelque chose. Deux ajustements ont gagné leur place :
- Une agrégation pondérée par la longueur. Une zone contient en général plusieurs détections. La confiance annoncée est la moyenne des scores de chaque détection, pondérée par la longueur du texte : une longue ligne de sujet bien lue n'est pas tirée vers le bas (ni artificiellement remontée) par un fragment de deux lettres.
- Un passage au correcteur orthographique, seulement sous 0,8. Les bandeaux sont en capitales, avec des lettres très serrées, et l'erreur classique d'EasyOCR est de coller les mots entre eux. Pour les détections peu sûres uniquement, chaque mot inconnu est testé contre un dictionnaire français, y compris toutes ses découpes possibles en deux mots :
bonjourmonderevient enbonjour monde. Les détections sûres ne sont pas touchées du tout. Retoucher un texte dont l'OCR était sûr, c'est le meilleur moyen d'abîmer de bonnes données.
Pour les erreurs résiduelles, il y a un service de correction à part, et ce n'est volontairement pas un modèle de pointe (frontier model) : OCRonos, un petit modèle entraîné spécifiquement pour corriger de l'OCR, quantifié en 8 bits, auto-hébergé derrière un endpoint Flask de 70 lignes avec des métriques Prometheus. Une tâche étroite n'a pas besoin d'un gros modèle. Il lui faut un modèle spécialisé, qui tient sur un GPU qu'on possède déjà et qui répond en quelques dizaines de millisecondes.
Un modèle de reconnaissance fine-tuné sur nos propres pixels
Le plus gros gain de précision n'est pas venu du post-traitement, mais du fine-tuning du modèle d'OCR lui-même. Le modèle de reconnaissance latin fourni avec EasyOCR est entraîné sur du texte de scène générique (scene text), et les incrustations télé sont tout sauf génériques. Chaque chaîne utilise la même poignée de polices, de couleurs et de fonds pendant des années, en capitales, avec des lettres serrées, toujours à la même taille. C'est un domaine visuel étroit, et le fine-tuning est fait précisément pour les domaines étroits.
Nous avons donc construit notre propre jeu d'entraînement à partir de la production : un script échantillonne des chunks vidéo et en extrait des découpes des zones de texte, un autre en fait un jeu de données annoté (la sortie du modèle d'origine, corrigée à la main, donne une première annotation tout à fait correcte). Sur cette base, nous avons fait le fine-tuning du réseau de reconnaissance d'EasyOCR avec la recette classique VGG + BiLSTM + CTC, en niveaux de gris, avec un jeu de caractères français (accents, ligatures, symbole euro), en partant des poids latin_g2 d'origine plutôt que de zéro.
Déployer un modèle de reconnaissance maison avec EasyOCR est d'une banalité reposante, il suffit d'un paramètre :
reader = easyocr.Reader(['fr', 'en'], recog_network='yacast_filtered')
Le détecteur reste celui d'origine ; seule la tête de reconnaissance est à nous. Résultat : un modèle de 15 Mo, entraîné sur un seul GPU, qui lit les incrustations de nos chaînes mieux que tous les modèles généralistes que nous avons essayés, et qui ne quitte jamais notre infrastructure. C'est la même leçon qu'avec OCRonos, un cran plus loin : quand le domaine est fermé, le chemin le moins cher vers la qualité passe par vos propres données, pas par un modèle plus gros.
L'enrichissement par LLM : un worker comme les autres
L'étape d'enrichissement prend une fenêtre de segments de transcription diarisés et demande à un modèle de renvoyer, pour chaque segment, un titre, cinq mots-clés, les personnes, lieux et organisations cités, un code thématique choisi dans une liste fermée de quinze (politique, économie, sport…), et ses dates de début et de fin, recopiées telles quelles. Côté architecture, c'est le même worker qui tire ses tâches d'une file (pull queue) que partout ailleurs dans la plateforme : récupérer la tâche, récupérer la fenêtre STT, appeler le modèle, valider, pousser les résultats, poser un code de statut par étape. Le LLM n'est qu'une dépendance capricieuse de plus.
Les leçons sont toutes dans le prompt et dans ce qui l'entoure :
- Le prompt est un contrat de sortie, pas une conversation. Le nôtre précise la forme exacte du tableau JSON, un objet par segment en entrée, des noms de champs d'une ou deux lettres (
t,k,sd,ed,p,l,o,c) pour limiter les tokens en sortie, et des interdictions explicites : ne jamais inventer ni modifier une date, ne jamais renvoyer le contenu de la transcription, ne jamais fusionner des segments. - Donner au modèle une porte de sortie sans surprise. Les segments non éditoriaux (jingles, boucles météo, transitions) doivent revenir en
t: "Inconnu", classe 15. Sans fourre-tout prévu pour ça, le modèle classe le bruit avec beaucoup d'imagination. - Demander la correction qu'on ferait de toute façon. Le prompt demande au modèle de normaliser les noms propres « manifestement phonétiques » : la transcription entend « Ursula fonderlayen », l'enrichissement renvoie la personne Ursula von der Leyen. Le LLM rattrape les erreurs du STT gratuitement, à la seule étape qui a assez de contexte pour le faire.
- Valider comme si ça allait échouer, parce que ça échouera. La réponse est parsée strictement ; un JSON malformé met la tâche en erreur, et le service de retry du core la remet en file. On ne parse jamais une réponse à moitié, et on ne repêche pas à coups de regex un JSON presque valide.
Auto-hébergé ou hébergé : un flag, pas une architecture
Le worker parle à son modèle via l'API chat completions compatible OpenAI, avec le nom du modèle et l'endpoint passés en flags de ligne de commande. Cette seule décision fait du backend un choix de déploiement plutôt qu'une réécriture : le même worker a tourné sur Ollama sur nos propres GPU et sur des API hébergées, et il tournera sur ce qui sortira gagnant de la prochaine évaluation.
Et c'est bien l'évaluation qui compte. Avant de brancher tout ça, nous avons mesuré les tâches de classification et d'extraction d'entités sur un mois annoté d'une chaîne d'info française, en comparant des modèles auto-hébergés Llama 3.1/3.2, Gemma 2 et PleIAs (via Ollama, température 0, mode JSON) à des modèles hébergés, CSV contre CSV, côte à côte. Bilan : la classification sur liste fermée est largement à la portée de petits modèles auto-hébergés ; regrouper les segments en blocs éditoriaux cohérents et corriger les noms propres de façon fiable, c'est là que les gros modèles justifient encore leur prix. L'endroit où tourne chaque tâche est un arbitrage prix/qualité que nous revoyons, et c'est justement pour ça qu'il doit rester un flag.
À retenir
- Le texte à l'écran est une métadonnée structurée, pas un problème d'image : des zones par chaîne stockées en base battent n'importe quel OCR générique sur l'image entière.
- Trouvez votre tri bon marché. Un contrôle quasi gratuit sur l'image décide si elle mérite d'être traitée, avant qu'un modèle coûteux ne tourne.
- La confiance doit survivre au post-traitement : ne corrigez que ce dont l'OCR n'était pas sûr, et pondérez les scores agrégés par la longueur du texte.
- Les petits modèles spécialisés (OCRonos pour la correction d'OCR) sont le gain discret de l'auto-hébergement : un GPU, une tâche étroite, aucune facture d'API.
- Quand le domaine visuel est fermé, faites un fine-tuning du modèle de reconnaissance sur vos propres images : un modèle de 15 Mo entraîné sur vos données bat un modèle généraliste sur vos chaînes.
- Traitez le LLM comme une étape de pipeline avec un contrat de sortie strict : vocabulaires fermés, valeurs de repli obligatoires, validation sans concession, relances. Jamais comme une conversation.
- Gardez le modèle derrière un flag compatible OpenAI, et relancez votre évaluation : la réponse à « auto-hébergé ou hébergé ? » dépend de la tâche, et elle change avec le temps.