Whisper 24 h/24 : transcrire la télé et la radio françaises sur une flotte de GPU
Dans le billet sur pgvector, j'expliquais comment on dédoublonne des milliers de voix de locuteurs dans PostgreSQL. Ce billet-ci parle de l'amont : d'où viennent ces transcriptions et ces embeddings de voix. Notre plateforme transcrit en continu des flux de télé et de radio françaises, avec des timestamps au mot près, la diarisation et l'identification des locuteurs. Les workers sont écrits en Python, avec PyTorch et ffmpeg, et tournent sans surveillance sur des machines multi-GPU.
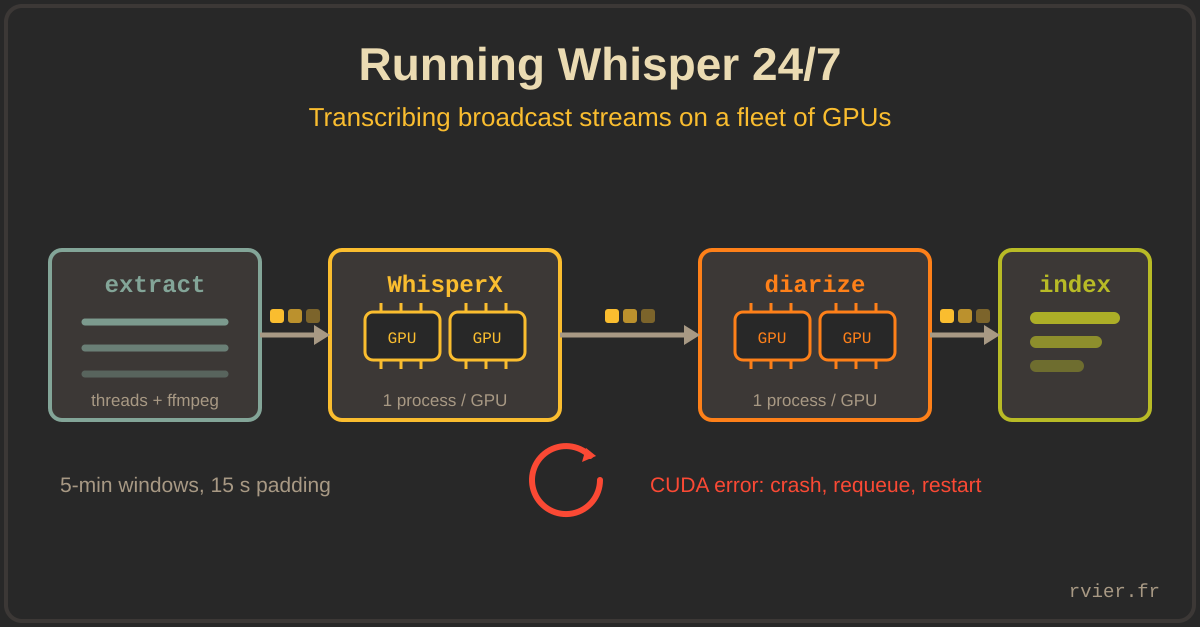
Faire tourner Whisper sur un fichier, c'est un tutoriel. Le faire tourner jour et nuit sur l'audio de chaînes en direct, sur des machines où personne ne se connecte, c'est un autre exercice : les problèmes intéressants se trouvent dans tout ce qui entoure le modèle, pas dans le modèle lui-même.
L'unité de travail : cinq minutes, plus une marge
Le flux est découpé en tâches de cinq minutes d'audio par chaîne. Chaque worker récupère des jobs (mediaid, timestamp) auprès d'une petite API de file d'attente. Ajouter de la capacité revient donc à démarrer une machine de plus : pas besoin d'ordonnanceur ni de logique d'affectation, les workers viennent se servir quand ils ont de la place.
En réalité, chaque tâche télécharge 15 secondes avant et après sa fenêtre. Les phrases ne s'arrêtent pas pile sur les frontières de cinq minutes, et Whisper comme le modèle de diarisation s'en sortent mal avec des mots coupés en deux. Les marges sont transcrites, puis rognées au moment de stocker les résultats. Une vérification des résultats existants rend le retraitement idempotent : une tâche remise dans la file alors qu'elle a déjà été traitée est acquittée puis ignorée.
Une machine, trois types de travail
Une machine worker fait tourner un seul programme Python, organisé en chaîne de files, parce qu'un serveur GPU mène de front trois charges de travail très différentes :
extraction (threads, network + ffmpeg)
   └─▶ whisperx queue ─▶ WhisperX (1 process per GPU)
          └─▶ diarization queue ─▶ diarization + embeddings (1 process per GPU)
                 └─▶ gender queue ─▶ segmentation (thread)
                        └─▶ result queue ─▶ XML export + indexing (threads)
Les étapes limitées par les entrées-sorties (téléchargement des chunks, conversion ffmpeg, envoi des résultats) sont de simples threads. Les étapes GPU sont de vrais processus, un par GPU, lancés avec le contexte multiprocessing spawn, et chacun charge ses propres modèles. L'étape d'extraction se freine d'elle-même quand la file de transcription dépasse un seuil. Une étape GPU trop lente ralentit ainsi tout le pipeline par contre-pression (back-pressure), au lieu de remplir le disque de fichiers WAV.
Placement des GPU, et vol de GPU à chaud
Sur une machine à 8 GPU, l'affectation statique alterne les deux étapes lourdes : les GPU impairs font tourner WhisperX (large-v3, float16), les GPU pairs la diarisation pyannote et l'extraction des embeddings. Cette alternance compte sur les machines bi-socket. Des GPU voisins partagent souvent un switch PCIe et la même enveloppe thermique, et associer un GPU de transcription à un GPU de diarisation répartit mieux la charge que de mettre toute une charge de travail du même côté.
Ce découpage statique n'est qu'une estimation. Le vrai rapport entre temps de transcription et temps de diarisation dépend du contenu (une radio parlée et une station surtout musicale ne se diarisent pas du tout pareil). La boucle de supervision rééquilibre donc à chaud, en surveillant les files :
- file de diarisation au-dessus de 100 éléments : on arrête un processus WhisperX et on relance ce GPU en worker de diarisation ;
- file de transcription chargée pendant que la diarisation n'a rien à faire : on rend le GPU.
C'est rudimentaire, plus un thermostat qu'un ordonnanceur, mais ça converge en deux ou trois cycles, et ça nous a débarrassés du réglage manuel machine par machine qu'on faisait au début.
Erreurs CUDA : laisser planter (crash-only)
La meilleure décision de conception du projet : un processus GPU n'essaie jamais de se remettre d'une erreur CUDA de l'intérieur. Quand une exception contient CUDA error, device-side assert ou out of memory, le processus remet son job en cours dans la file (avec un nombre de tentatives limité), écrit dans les logs et appelle sys.exit(1).
On a d'abord essayé l'inverse. Après certaines erreurs CUDA, le contexte est empoisonné : les inférences suivantes renvoient n'importe quoi ou restent bloquées, et les incantations à base de torch.cuda.empty_cache() ne font que masquer le problème. Un processus mort laisse un état propre ; un processus « rétabli » reste un point d'interrogation.
Le redémarrage est pris en charge à plusieurs niveaux :
- la boucle de supervision vérifie toutes les 30 secondes que chaque processus GPU est vivant, et relance les morts sur le même GPU ;
- supervisord redémarre tout le worker si le processus principal meurt ;
- le script de déploiement tue les processus GPU qui traînent et redémarre la machine, parce que repartir d'un état CUDA neuf au déploiement coûte une minute, alors que déboguer un GPU à moitié libéré coûte un après-midi.
Les jobs qui ont épuisé leurs tentatives sont marqués dans l'API de file avec un statut d'erreur propre à chaque étape (erreur de téléchargement, de transcription, de diarisation...). Savoir ce qui échoue, et où, tient alors en une seule requête.
L'audio broadcast n'est jamais propre
L'audio arrive sous forme de chunks MPEG-TS, servis par le service de stockage de notre plateforme de captation. Deux réalités de la captation broadcast ont façonné l'étape d'extraction.
Des chunks manquent. Rééquilibrage du stockage, ratés de captation : parfois un chunk n'est pas là. Le sauter décalerait sans prévenir tous les timestamps suivants de la fenêtre, et les timestamps sont le produit (ce sont eux qui placent chaque mot sur la timeline de l'antenne). Un chunk manquant est donc remplacé par un chunk de silence généré de même durée (ffmpeg -f lavfi -i anullsrc), et le job n'abandonne qu'au-delà d'un seuil de chunks manquants. La transcription perd les mots manquants ; tous les autres mots gardent leur position exacte.
Les PTS sont discontinus. Concaténer bêtement des chunks TS perturbe les décodeurs, parce que les timestamps de présentation sautent d'un chunk à l'autre. Le démuxeur concat de ffmpeg (une liste de fichiers et -f concat, plutôt qu'une concaténation binaire) réécrit une timeline cohérente avant la conversion en WAV mono 16 kHz pour le pipeline.
Les chunks téléchargés sont eux-mêmes écrits dans un fichier temporaire, synchronisés sur disque (fsync), puis renommés. C'est la même habitude d'écriture atomique que partout ailleurs dans la plateforme, parce qu'un fichier TS tronqué produit les erreurs les plus bizarres plus loin dans la chaîne.
Les réglages de Whisper qui comptent ici
Le choix du modèle et les options de décodage n'ont rien d'original (large-v3, float16, inférence par batch, beam 5). Trois réglages ont gagné leur place en production sur du contenu broadcast :
condition_on_previous_text: False. Le conditionnement sur le texte précédent aide à la cohérence sur une parole propre, et il amplifie les boucles d'hallucination sur les jingles, les tapis musicaux et les silences. Sur de l'audio broadcast, l'arbitrage est vite fait : une transcription qui répète quarante fois « merci d'avoir regardé » est pire qu'une ponctuation un peu moins fluide.- Une détection d'activité vocale (VAD) permissive devant le modèle (pyannote, onset et offset à 0,1, là où WhisperX est par défaut à 0,5 et 0,363). Whisper hallucine sur ce qui n'est pas de la parole, donc la VAD retire ce qui n'en est clairement pas ; les seuils bas évitent de couper au passage une voix posée sur un tapis musical.
- L'alignement au niveau du mot dans une passe séparée (WhisperX). Les timestamps de segments que donne Whisper sont trop grossiers pour attribuer les mots aux tours de parole issus de la diarisation. C'est la passe d'alignement forcé qui permet tout simplement de savoir qui a dit quel mot.
Des voix aux identités
La diarisation (pyannote) répond « locuteur A, locuteur B » à l'intérieur d'une fenêtre de cinq minutes. Pour en faire des personnes, l'étape de diarisation extrait aussi un embedding par locuteur détecté : les segments de moins de 5 secondes sont ignorés (les extraits trop courts font planter la fenêtre d'embedding, et donnent de toute façon des vecteurs bruités), les autres sont moyennés. L'embedding est envoyé à l'API des locuteurs, qui fait la recherche par similarité pgvector du billet précédent et renvoie un UUID de locuteur stable, retrouvé ou nouvellement créé.
Deux détails sur la gestion des pannes :
- Les segments diarisés qui se retrouvent sans étiquette de locuteur héritent de celle du segment étiqueté le plus proche dans le temps. C'est grossier, mais mesurablement mieux que de jeter les mots.
- Si l'API des locuteurs reste injoignable après plusieurs tentatives espacées (backoff), le worker génère des UUID de secours déterministes et envoie quand même la transcription. On peut réconcilier l'identité des locuteurs plus tard, alors qu'un trou dans la timeline de transcription 24 h/24 ne se rattrape pas.
À retenir
- Le modèle, c'est la partie facile. Le travail d'ingénierie est dans le pipeline autour : les files, les marges, les relances, et le principe que chaque étape finira par tomber en panne.
- Laisser mourir les processus GPU. Le crash-only sur erreur CUDA, avec des redémarrages à plusieurs niveaux (boucle de supervision, supervisord, reboot au déploiement), a battu toutes les reprises à l'intérieur du processus qu'on a essayées.
- Rééquilibrer les GPU comme un thermostat, pas comme un ordonnanceur : surveiller les files, déplacer un GPU à la fois.
- Ne jamais laisser une entrée manquante décaler la timeline : injecter du silence, garder des timestamps justes.
- Passer en mode dégradé plutôt que s'arrêter : identifiants de locuteur de secours, repli sur le locuteur le plus proche, seuils de silence tolérés. Un pipeline 24 h/24 doit avant tout continuer à tourner.