Enregistrer la télé et la radio 24 h/24 : l'architecture d'une plateforme de captation
Jusqu'ici, tous les billets de cette série partaient de la même matière première : la transcription avec Whisper, l'OCR des textes à l'écran, le dédoublonnage des locuteurs, et même le format binaire des profils audio reproduit à l'octet près. Ce billet parle de sa provenance : la plateforme qui enregistre en continu des chaînes de télé et de radio françaises, à partir des multiplex DVB de la TNT, d'antennes FM, du satellite, de webradios et de sources IP, et qui le fait depuis des années.
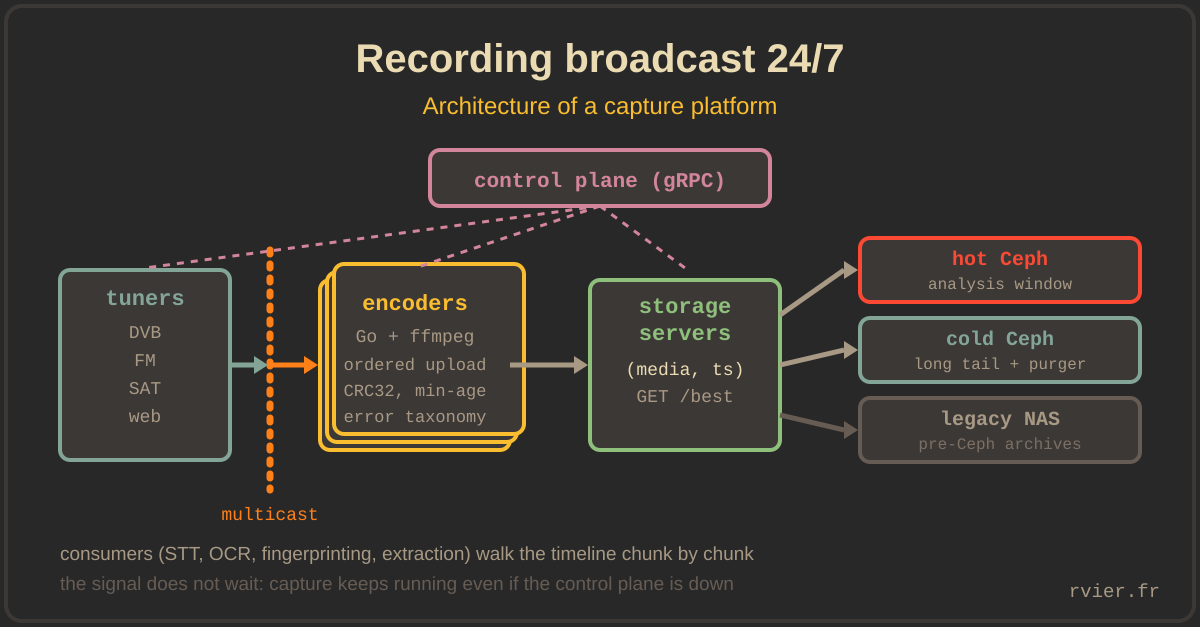
Une plateforme de captation a une propriété non négociable, qui conditionne toutes les autres décisions : le signal n'attend pas. Quand un service web est en panne, on réessaie plus tard ; une minute d'antenne qui n'a pas été enregistrée est perdue pour toujours. Tout ce qui suit en découle.
Une abstraction pour les gouverner tous : le segment adressé par le temps
Tout le système s'accorde sur un seul modèle de données : un enregistrement est une suite de segments (chunks) MPEG-TS immuables, adressés par (media, timestamp). L'adresse se résume à un identifiant de chaîne et une heure UTC, sans nom de fichier, playlist ni session.
Tous les composants utilisent cette adresse, et rien d'autre. Les encodeurs produisent les segments et les envoient. Côté stockage, les serveurs les conservent et les servent en HTTP, avec la durée du segment dans un en-tête de réponse, pour qu'un consommateur puisse parcourir la timeline segment par segment. Les workers de STT, d'OCR et de fingerprinting des billets précédents vont chercher (media, t), puis (media, t + len), et ainsi de suite. L'adresse ne dit rien de l'emplacement physique, donc un segment peut vivre sur n'importe quel niveau de stockage sans que personne ne le remarque. Le service de purge applique la rétention en supprimant des plages d'adresses.
Chaque chaîne est en plus enregistrée en plusieurs qualités, chacune avec sa propre rétention : les profils vidéo high, low et verylow, plus un profil raw qui ne garde que l'audio, dans son format de diffusion d'origine, pour des analyses audio ultérieures. Les profils coûteux vivent moins longtemps que les profils bon marché, et c'est comme ça que « tout garder » reste abordable. Par-dessus, l'API de stockage expose un endpoint best : donne-moi cette minute, dans la meilleure qualité disponible à cet instant. Les consommateurs expriment une intention, la couche de stockage la résout. Quand un segment haute qualité manque ou a déjà été purgé mais qu'une qualité inférieure existe, le pipeline continue de tourner au lieu d'échouer.
Le plan de données : tuners, multicast, encodeurs
L'acquisition et l'encodage tournent volontairement sur des machines séparées, avec un réseau multicast entre les deux :
DVB / FM / satellite / web-radio tuners
        │  (UDP multicast, one group per stream)
        ▼
encoders (Go service driving ffmpeg, N per site)
        │  (HTTP, ordered chunk upload)
        ▼
storage servers ("blobbers") ─▶ hot and archive tiers
Le multicast sert de couche de découplage, et il est difficile d'exagérer tout ce qu'il simplifie. Un tuner émet un flux ; autant de consommateurs qu'on veut peuvent rejoindre le groupe : l'encodeur nominal, un encodeur de secours en train de démarrer, le ffprobe d'un ingénieur pendant un incident, sans que le tuner le sache ni s'en soucie. Basculer un encodage sur une autre machine revient à rejoindre un groupe multicast, sans rien recâbler côté source. Les tuners eux-mêmes restent légers : ils pilotent le frontend DVB, transmettent les flux de transport et exportent des métriques de signal (RSSI compris), pour qu'une antenne qui se dégrade apparaisse dans le monitoring avant de devenir un trou dans l'archive.
L'encodeur est un superviseur en Go autour de ffmpeg, et son changelog est un musée de tout ce qui peut mal tourner entre une source en direct et un fichier immuable. Les leçons qui sont restées :
- Envoyer les segments strictement dans l'ordre pour une même chaîne, en parallèle d'une chaîne à l'autre. Les consommateurs en aval parcourent la timeline ; un envoi dans le désordre ressemble exactement à un trou.
- Ne jamais envoyer un fichier qui est peut-être encore en cours d'écriture. On impose un âge minimum avant l'envoi, parce que « le fichier existe » et « le fichier est complet » sont deux affirmations différentes.
- Lire le fichier une seule fois, pour la somme de contrôle comme pour le corps HTTP. Une première version le lisait deux fois, et pouvait calculer le checksum d'un flux d'octets différent de celui qu'elle envoyait. D'abord le CRC, puis on envoie ces mêmes octets.
- Classer les causes de mort. Chaque façon dont un encodage peut échouer (ffmpeg qui meurt, segments qui n'avancent plus, PTS qui sautent au-delà d'une amplitude plausible, timestamps venus du futur) inscrit une raison d'erreur explicite dans la fiche de l'encodage. « Ça s'est arrêté » n'est pas un diagnostic.
- Faire du sondage d'une source une opération à part entière. Un appel RPC dédié sonde une source (multicast, SRT, HTTP) sans lancer d'encodage, si bien que vérifier qu'une source est vivante ne demande pas de toucher à l'état de production.
- Signer son travail. Chaque encodeur écrit son nom d'hôte dans les métadonnées MPEG-TS de ce qu'il produit. Quand un segment défectueux refait surface des semaines plus tard, on sait quelle machine l'a fabriqué.
L'encodage vidéo lui-même tourne sur GPU et sur du matériel de transcodage dédié (H.264/H.265, désentrelacement compris), et le service d'encodage reste volontairement agnostique quant à l'accélérateur qui se trouve derrière ffmpeg.
Un plan de contrôle qui peut tomber sans couper l'enregistrement
Au-dessus du plan de données se trouve un superviseur, Hyperion Core. Il porte l'API REST authentifiée qu'utilisent les outils internes, une petite API publique qui expose la disponibilité, des métriques Prometheus, et des liens gRPC vers chaque tuner, encodeur et service de purge. C'est lui qui détient la source de vérité, dans PostgreSQL : quelles chaînes existent, où elles sont encodées, quelles sont les règles de rétention.
La règle de conception est simple : le plan de contrôle configure le plan de données, mais ne se trouve jamais à l'intérieur. Les segments vont directement des encodeurs au stockage ; si le core est en panne, les tuners continuent de capter, les encodeurs d'encoder et les envois de partir. On perd la possibilité de modifier la configuration, pas l'enregistrement lui-même. Pour un système dont le produit se résume à « on ne l'a pas raté », cette séparation est la décision d'architecture qui protège le plus.
Le stockage : plusieurs niveaux derrière une seule API
Derrière les serveurs de stockage, les données sont réparties sur plusieurs niveaux : un cluster Ceph chaud pour la fenêtre récente, celle que les workers d'analyse sollicitent sans arrêt, un cluster Ceph froid pour la longue traîne, et quelques vieux volumes NAS d'avant l'installation de Ceph, qui servent toujours tranquillement les segments de leur époque. Le service de purge applique la rétention chaîne par chaîne. Comme tout est adressé par (media, timestamp), les niveaux sont invisibles pour les consommateurs : la même requête est servie depuis l'endroit où se trouve le segment.
Les segments peuvent migrer d'un niveau à l'autre, mais volontairement à la main : un outil en ligne de commande déplace une chaîne sur une plage horaire quand il y a une raison de le faire (libérer un niveau, regrouper une archive), plutôt qu'un déménageur automatique qui brasse les données en arrière-plan. C'est aussi ce qui nous a fait survivre aux changements de génération de stockage. Les archives d'avant Ceph n'ont jamais eu à être migrées avant une date butoir : elles sont restées derrière la même API pendant que les nouvelles écritures partaient sur Ceph, et on les déplace plage par plage quand ça en vaut vraiment la peine.
C'est l'immuabilité qui rend tout ça sans histoire. Un segment est écrit une fois et jamais modifié, donc la réplication, la migration et le cache n'ont jamais à se soucier de cohérence : les astuces tmpfs d'un billet précédent fonctionnent justement parce qu'un segment en cache ne peut jamais être périmé.
Ranger les segments dans des blobs
Il y a encore une couche entre « segment » et « disque », et elle existe pour une question d'arithmétique. Un segment dure quelques secondes ; multipliez par quatre qualités au plus, par toutes les chaînes, par 24 h/24, par des années, et vous obtenez des centaines de millions de petits fichiers. Les systèmes de fichiers détestent ça : pression sur les inodes, listings de répertoires qui prennent des minutes, sauvegardes et vérifications d'intégrité (scrubs) dominées par les métadonnées plutôt que par les données. Les petits fichiers sont le moyen classique de tuer un cluster de stockage avec un volume de données qui, au total, n'est même pas si gros.
Les segments ne sont donc pas stockés comme des fichiers. Un démon de stockage (affectueusement baptisé Blobibloba, d'où les « blobbers ») les écrit à la suite dans des fichiers blob : un blob par chaîne, par qualité et par fenêtre de temps fixe, la fenêtre étant simplement le timestamp du segment tronqué. À côté de chaque blob vit un petit fichier d'index qui associe le timestamp d'un segment à un offset et une longueur, et chaque entrée porte la durée du segment, son CRC32 et un drapeau de discontinuité. Servir (media, t), c'est une recherche dans l'index et une lecture à une position donnée ; l'ajout se fait en écriture séquentielle, exactement ce qu'aiment aussi bien les disques à plateaux que Ceph.
Ce découpage par fenêtres de temps apporte gratuitement deux propriétés :
- La localité suit les accès. Les consommateurs lisent des timelines, et une timeline correspond à des octets contigus dans un seul blob, au lieu d'un millier d'ouvertures de fichiers éparpillées sur un cluster.
- La rétention devient de l'arithmétique sur des répertoires. Le service de purge parcourt les répertoires de blobs et supprime des fenêtres de temps entières une fois dépassée leur rétention, propre à chaque qualité (le profil high n'a pas à vivre aussi longtemps que le low). Supprimer une journée d'une chaîne revient à retirer une poignée de blobs, au lieu d'effacer des dizaines de milliers de fichiers.
Au-dessus des blobs, les serveurs de stockage tiennent la table de routage (quel niveau de stockage sert quelle chaîne sur quelle période, mise en cache dans Redis), tandis que les fichiers d'index des blobs restent la source de vérité sur ce qui existe : il n'y a pas de base de segments séparée à garder cohérente avec les octets sur disque. Les serveurs de stockage exposent les lectures de plus haut niveau : des segments à l'unité, et des extraits en streaming sur des plages horaires quelconques, qui concatènent les segments à la volée avec ffmpeg, décalages de PTS cumulés à travers les discontinuités compris, le tout mis en cache en respectant vraiment la sémantique HTTP (Range, ETag, 304 Not Modified).
La couche de réparation : partir du principe que rien n'est parfait
Le constat inconfortable de la captation en continu, c'est qu'il y a toujours quelque chose d'un peu cassé : une antenne se dégrade, un multiplex a un raté, une machine redémarre. La plateforme traite les trous comme un objet d'exploitation normal, et non comme une exception :
- des vérificateurs parcourent la timeline et signalent les discontinuités chaîne par chaîne, si bien qu'un trou est détecté en quelques minutes, au lieu d'être découvert par un client des mois plus tard ;
- un outil de récupération réimporte les plages manquantes depuis des captations secondaires et des récepteurs de secours, et ne comble que les vrais trous, sauf si on le force explicitement ;
- les consommateurs passent en mode dégradé au lieu de s'arrêter : les workers STT injectent du silence à la place d'un segment manquant pour que la timeline de la transcription reste honnête.
Détecter, réparer, fonctionner en mode dégradé : trois mécanismes séparés, parce qu'aucun n'est assez fiable à lui seul.
À retenir
- Choisissez une adresse unique pour vos données et imposez-la à tous les composants. Avec
(media, timestamp)pour un segment immuable, la hiérarchie de stockage, la rétention, la réparation et chaque pipeline d'analyse sont devenus des problèmes indépendants. - Le multicast entre l'acquisition et le traitement est la brique de haute disponibilité la moins chère qui existe : un producteur, autant de consommateurs qu'on veut, aucun couplage.
- Laissez les consommateurs exprimer une intention (la qualité
best), pas des chemins de stockage. C'est la différence entre un service dégradé et une panne. - Gardez le plan de contrôle hors du chemin des données. Une panne de configuration est acceptable, une panne de captation ne l'est pas.
- Faites le calcul des petits fichiers avant que votre système de fichiers ne le fasse pour vous : rangez les segments dans des blobs par fenêtre de temps, avec un index, et la rétention se résume à supprimer quelques gros fichiers au lieu de millions de petits.
- Segments immuables, envois ordonnés, checksums calculés sur les octets réellement envoyés, un nom pour chaque mode de défaillance : la qualité d'une archive est la somme de ces petites disciplines.
- Construisez la couche de réparation dès le premier jour. Une plateforme 24 h/24 tombe en panne comme les autres ; elle tient parce qu'elle remarque la panne, la répare et fonctionne honnêtement en mode dégradé.